


 contact@icitech.net
 0356087075

 VI
 EN
 JA
Bí Mật Đằng Sau Nút "Gợi Ý Cho Bạn": 5 Sự Thật Bất Ngờ Về Hệ Thống Khuyến Nghị Hiện Đại
 20 March 2026
1. Ma trận Utility: Khi sở thích cá nhân là những con số trong bài toán giải đố
Dưới góc nhìn của một nhà nghiên cứu AI, sở thích của bạn không phải là những cảm xúc mơ hồ mà được biểu diễn toán học thông qua một cấu trúc gọi là Ma trận Utility.
Hãy tưởng tượng một bảng dữ liệu khổng lồ: mỗi hàng là một người dùng, mỗi cột là một sản phẩm. Trong thực tế, ma trận này cực kỳ "thưa" (Sparse) vì một người dùng chỉ có thể tương tác với một phần rất nhỏ trong hàng triệu sản phẩm hiện có. Bài toán gợi ý thực chất là bài toán "Hoàn thiện ma trận" (Matrix Completion). AI sẽ dựa vào những "ô đen" (dữ liệu đã biết như đánh giá sao, lượt mua) để dự đoán giá trị đánh giá (ví dụ từ 1 đến 5 sao) mà bạn sẽ dành cho những "ô trống" (sản phẩm bạn chưa xem).
"Ma trận utility: Mỗi hàng thể hiện một người dùng, mỗi cột thể hiện một sản phẩm. Các ô có chấm đen thể hiện đã có thông tin về mức độ quan tâm của người dùng tới sản phẩm tương ứng. Bài toán đặt ra là dự đoán mức độ quan tâm ở những ô trống dựa trên những ô đen đã biết trước giá trị." (Nguồn: Machine Learning cơ bản)
2. "Vòng lặp phản hồi" và thách thức của sự quá hiểu khách hàng
Sự chính xác tuyệt đối đôi khi lại là một cái bẫy kỹ thuật mang tên Vòng lặp phản hồi (Feedback Loop).
Nếu hệ thống nhận thấy bạn thích xem video về mèo và liên tục tràn ngập trang chủ bằng nội dung này, bạn sẽ tiếp tục click vào chúng. Kết quả là nhãn dữ liệu (labels) thu được sẽ khiến thuật toán hội tụ (converge) về một tập hợp nội dung hẹp, nhốt bạn vào một "bong bóng thông tin" (Filter Bubble). Điều này làm mất đi tính đa dạng và sự bất ngờ (serendipity) – những yếu tố quan trọng để giữ chân người dùng lâu dài.
Bên cạnh đó, các chuyên gia còn phải đối mặt với hiệu ứng đuôi dài (Long-tail effect): những sản phẩm phổ biến thì quá nhiều dữ liệu, trong khi đại đa số các sản phẩm ít tên tuổi lại có rất ít phản hồi, khiến chúng gần như "vô hình" trước các thuật toán truyền thống. Việc cân bằng giữa Phản hồi tường minh (Explicit feedback - như lượt đánh giá sao) và Phản hồi ẩn (Implicit feedback - như thời gian dừng chuột hay lượt click) là chìa khóa để giải mã thực sự tâm ý người dùng.
3. "Khởi đầu lạnh" (Cold Start): Làm sao để gợi ý khi không biết bạn là ai?
Thách thức lớn nhất đối với bất kỳ hệ thống RS nào là khi dữ liệu quá ít – hiện tượng Khởi đầu lạnh. Làm thế nào để gợi ý phim cho một tài khoản vừa mới lập, hoặc bán một món hàng vừa mới lên kệ chưa có ai mua?
Để "phá băng", các hệ thống hiện đại áp dụng các chiến thuật thông minh sau:
Dựa vào ngữ cảnh (Context-aware): Sử dụng vị trí địa lý, ngôn ngữ, thời gian truy cập hoặc thậm chí là thời tiết tại khu vực của người dùng.
Thông tin thiết bị: AI suy đoán từ loại thiết bị (iPhone đời mới hay máy tính cũ), hệ điều hành và trình duyệt để đưa ra các gợi ý phù hợp với phân khúc khách hàng.
Sử dụng sản phẩm xu hướng (Trending): Gợi ý các sản phẩm đang "hot" trong cộng đồng để phục vụ những người dùng chưa xác định.
Logic "Thường mua cùng nhau" (Frequently bought together): Tận dụng mối quan hệ giữa các mặt hàng từ dữ liệu cộng đồng để gợi ý cho người dùng mới dựa trên chính sản phẩm họ đang xem, thay vì dựa trên lịch sử cá nhân.
4. Từ lọc cộng tác đến Mạng Nơ-ron: Sự trỗi dậy của Autoencoders
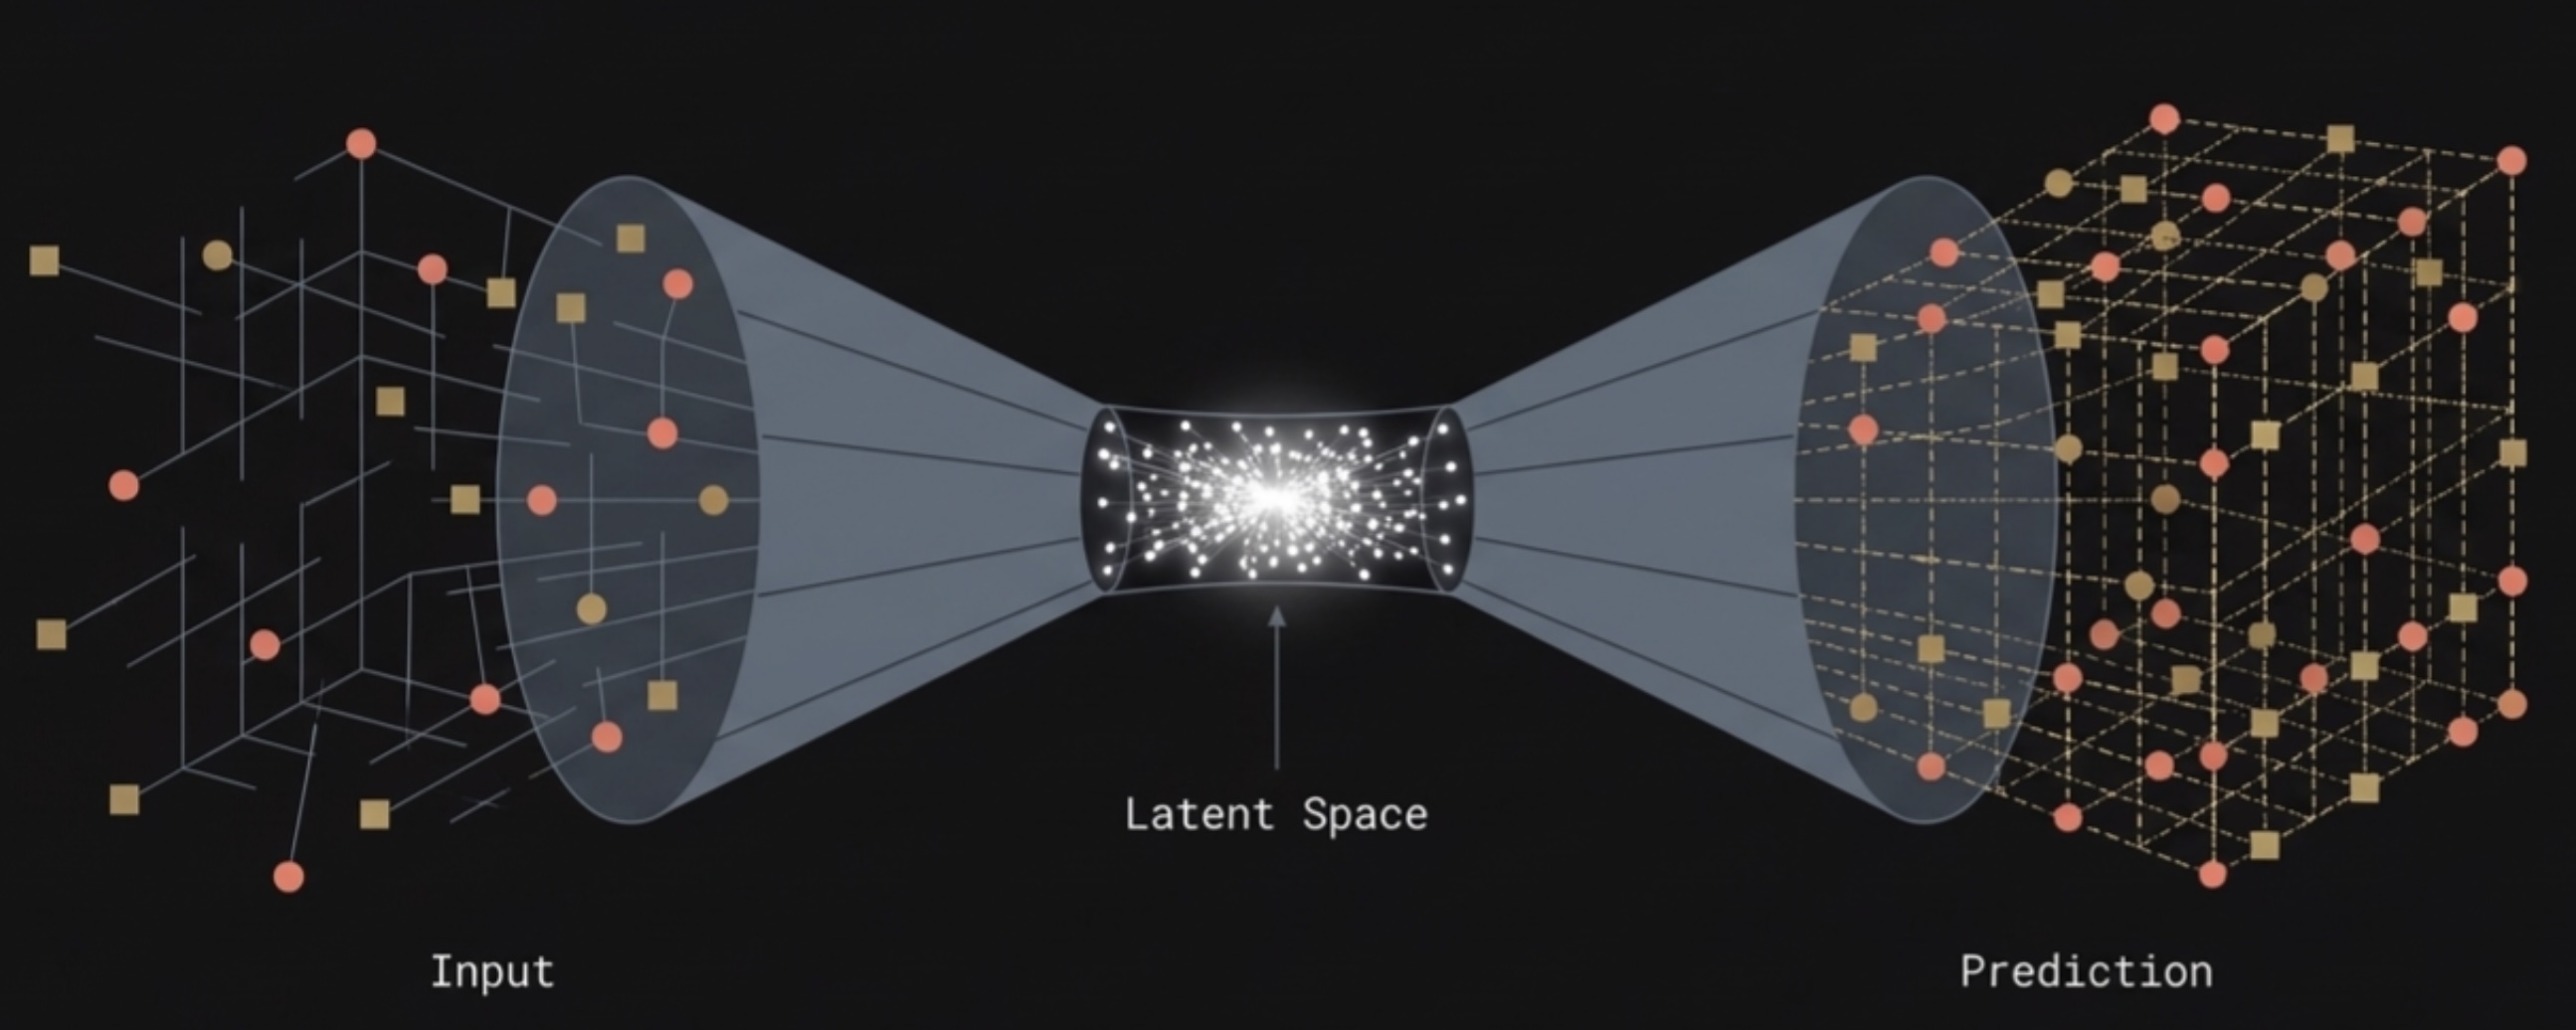
Công nghệ gợi ý đã tiến một bước dài từ phương pháp Lọc cộng tác (Collaborative Filtering) truyền thống dựa trên việc tìm kiếm "hàng xóm" có sở thích tương đồng, sang việc sử dụng các mạng nơ-ron sâu (Deep Learning) để học các biểu diễn tiềm ẩn (latent representation) phức tạp.
Autorec/I-Autorec: Thay vì các phép toán tuyến tính đơn giản, Autorec sử dụng các hàm kích hoạt phi tuyến (non-linear) như Sigmoid để mô hình hóa sở thích người dùng một cách sắc sảo hơn.
CI-Autorec: Đây là bước đột phá giúp giải quyết vấn đề dữ liệu thưa thớt. Bằng cách khai thác sự chênh lệch về kích thước giữa tầng đầu vào và đầu ra, mô hình này cho phép "tiêm" thêm thông tin nội dung (tags, mô tả) vào encoder, giúp hệ thống khám phá được các mối quan hệ ẩn giữa các thẻ nội dung mà mắt thường không thấy được.
Sparse Autoencoder: Để loại bỏ nhiễu, các nhà nghiên cứu thêm vào ràng buộc chuẩn hóa L1 (L1 regularization). Cơ chế này buộc phần lớn các nút ẩn phải về giá trị không, giúp mô hình tập trung vào một bộ biểu diễn cô đọng nhất, chỉ giữ lại các đặc trưng cốt lõi để dự đoán sở thích của bạn.
5. Những con số không biết nói dối: Hiệu quả thực tế của sự kết hợp
Sức mạnh của các mô hình lai (Hybrid models) – kết hợp giữa hành vi cộng đồng và thông tin nội dung – đã được chứng minh qua những con số thực nghiệm trên các tập dữ liệu khổng lồ như MovieLens 20M và BookGenome.
Một mô hình kết hợp giữa CI-Autorec và lớp Sparse mang lại những cải thiện vượt trội:
Giảm sai số (RMSE): Giảm từ 1.20% đến 5.69% so với các mô hình phổ biến như SVD (phân rã ma trận) trên tập MovieLens 20M.
Tăng độ chính xác (Precision/Recall): Cải thiện khoảng 0.15% - 2.06% trong các tác vụ xếp hạng Top-K sản phẩm.
So với Autorec thuần túy: Ngay cả khi so với các mạng nơ-ron cơ bản, mô hình lai vẫn giúp giảm RMSE thêm 0.31% - 3.74%.
Trong thế giới thương mại điện tử, chỉ cần một tỷ lệ cải thiện 1% về độ chính xác cũng có thể mang lại doanh thu hàng triệu đô la và sự gắn bó bền vững của khách hàng.
Kết luận: Tương lai của sự thấu hiểu
Hệ thống gợi ý không đơn thuần chỉ là một công cụ bán hàng; chúng là nhịp cầu cá nhân hóa, giúp con người tiết kiệm thời gian và khám phá những giá trị tiềm ẩn trong "đại dương" thông tin. Tuy nhiên, khi các thuật toán ngày càng thấu hiểu chúng ta hơn cả chính bản thân mình, một câu hỏi quan trọng cần được đặt ra: Đâu là ranh giới giữa việc "được hỗ trợ" để tìm thấy điều mình cần và việc "bị thao túng" bởi các thuật toán trong tương lai?
Hy vọng qua bài viết này, bạn đã có cái nhìn sắc sảo hơn về những "bánh răng" AI đang âm thầm vận hành sau mỗi nút bấm trên màn hình điện thoại của mình.





0 Bình luận